Kaum ein Prompting-Tipp hat sich so tief in die Nutzung von KI-Chatbots eingebrannt wie der Satz: „Denke Schritt für Schritt“. Viele haben ihn in ihre Prompts übernommen, weil er bei Rechen- und Logikaufgaben oft bessere Antworten lieferte. Doch seit ChatGPT, Claude und Gemini eigene Denk-Modi besitzen, hat sich die Wirkung dieses Tricks grundlegend verändert.
Kurz erklärt
Chain-of-Thought-Prompting (CoT) bringt ein Sprachmodell dazu, Zwischenschritte auszuschreiben, bevor es die eigentliche Antwort gibt. Der bekannteste Auslöser dafür war 2022 der Zusatz „Let’s think step by step“. Heute übernehmen viele moderne KI-Modelle diesen Prozess automatisch über einen eigenen Denk-Modus. Das verändert die Wirkung der klassischen Anweisung im Arbeitsalltag erheblich. Chain-of-Thought ist eine von mehreren Techniken, die wir im Überblick Prompt-Techniken für Profis vorstellen.
Was ist Chain-of-Thought-Prompting?
Sprachmodelle wie ChatGPT erzeugen Text Wort für Wort auf Basis von Wahrscheinlichkeiten. Bei komplexen Aufgaben wie Rechenproblemen oder logischen Schlussfolgerungen führt das manchmal dazu, dass ein Modell zu schnell zu einer falschen Antwort springt. Es durchläuft die notwendigen Zwischenschritte nicht explizit.
Chain-of-Thought-Prompting setzt genau hier an. IBM beschreibt es als Technik, die ein Modell durch einen schrittweisen Denkprozess führt. Sie fordert das Modell auf, seinen Lösungsweg auszuschreiben, bevor es das finale Ergebnis liefert. Diese sichtbaren Zwischenschritte helfen der KI, die Aufgabe präziser zu bearbeiten.
Woher die Technik kommt
Mit Beispielen vorrechnen
Der Ursprung liegt in einer Studie eines Google-Teams um Jason Wei aus dem Jahr 2022. Die Forscher zeigten, dass man Sprachmodellen anhand vorgerechneter Beispiele demonstrieren kann, wie man ein Problem in Zwischenschritte zerlegt. Diese Methode heißt Few-Shot-CoT. Das Modell erhielt dabei mehrere Beispielaufgaben inklusive ausführlicher Lösungswege, bevor es die eigentliche Aufgabe bearbeitete.
Ein Satz reicht: „Let’s think step by step“
Noch bemerkenswerter war eine Entdeckung von Takeshi Kojima und Kollegen im selben Jahr. Es reichte bereits ein einziger Satz, um denselben Effekt zu erzielen, ganz ohne vorgerechnete Beispiele. Diese Methode nennt sich Zero-Shot-CoT.
Die Ergebnisse beeindruckten, gemessen mit Modellen von 2022 wie InstructGPT und PaLM. Bei dem einfachen Rechentest MultiArith stieg die Trefferquote von 17,7 auf 78,7 Prozent. Bei dem komplexeren Mathe-Test GSM8K verbesserte sich die Genauigkeit von 10,4 auf 40,7 Prozent.
Warum das funktioniert hat
Der Grund für diesen Leistungssprung hängt mit der Arbeitsweise der Sprachmodelle zusammen. Sie generieren Text sequenziell, Wort für Wort. Schreibt ein Modell zunächst Zwischenschritte aus, baut es bei den folgenden Wörtern direkt darauf auf. Die sichtbaren Denkschritte werden selbst zu einem Teil der Eingabe für die nächsten Berechnungen und erhöhen die Wahrscheinlichkeit einer korrekten Lösung.
Was Reasoning-Modelle ändern
Mit der Einführung von Reasoning-Modellen hat sich die Situation gedreht. Diese Modelle, die in ChatGPT, Claude und Gemini über einen Denk-Modus verfügbar sind, arbeiten intern in Zwischenschritten, bevor sie eine Antwort formulieren.
Was OpenAI, Anthropic und Google empfehlen
OpenAI rät ausdrücklich davon ab, bei Reasoning-Modellen „Schritt für Schritt“ oder „erkläre deine Überlegungen“ zu verlangen. Das sei unnötig, weil diese Modelle intern ohnehin so vorgehen.
Anthropic nennt manuelles Chain-of-Thought-Prompting nur noch als Ausweg, wenn der Denk-Modus ausgeschaltet ist. Ist er aktiv, empfiehlt Anthropic allgemeine Anweisungen wie „denke gründlich nach“ statt einer vorgeschriebenen Abfolge von Einzelschritten, weil das Modell oft gründlicher überlegt, als ein Mensch es vorgeben würde. Google sagt in seiner Dokumentation zum Denk-Modus nicht ausdrücklich, ob die Anweisung dort zusätzlich hilft oder schadet.
Was die Wharton-Studie gemessen hat
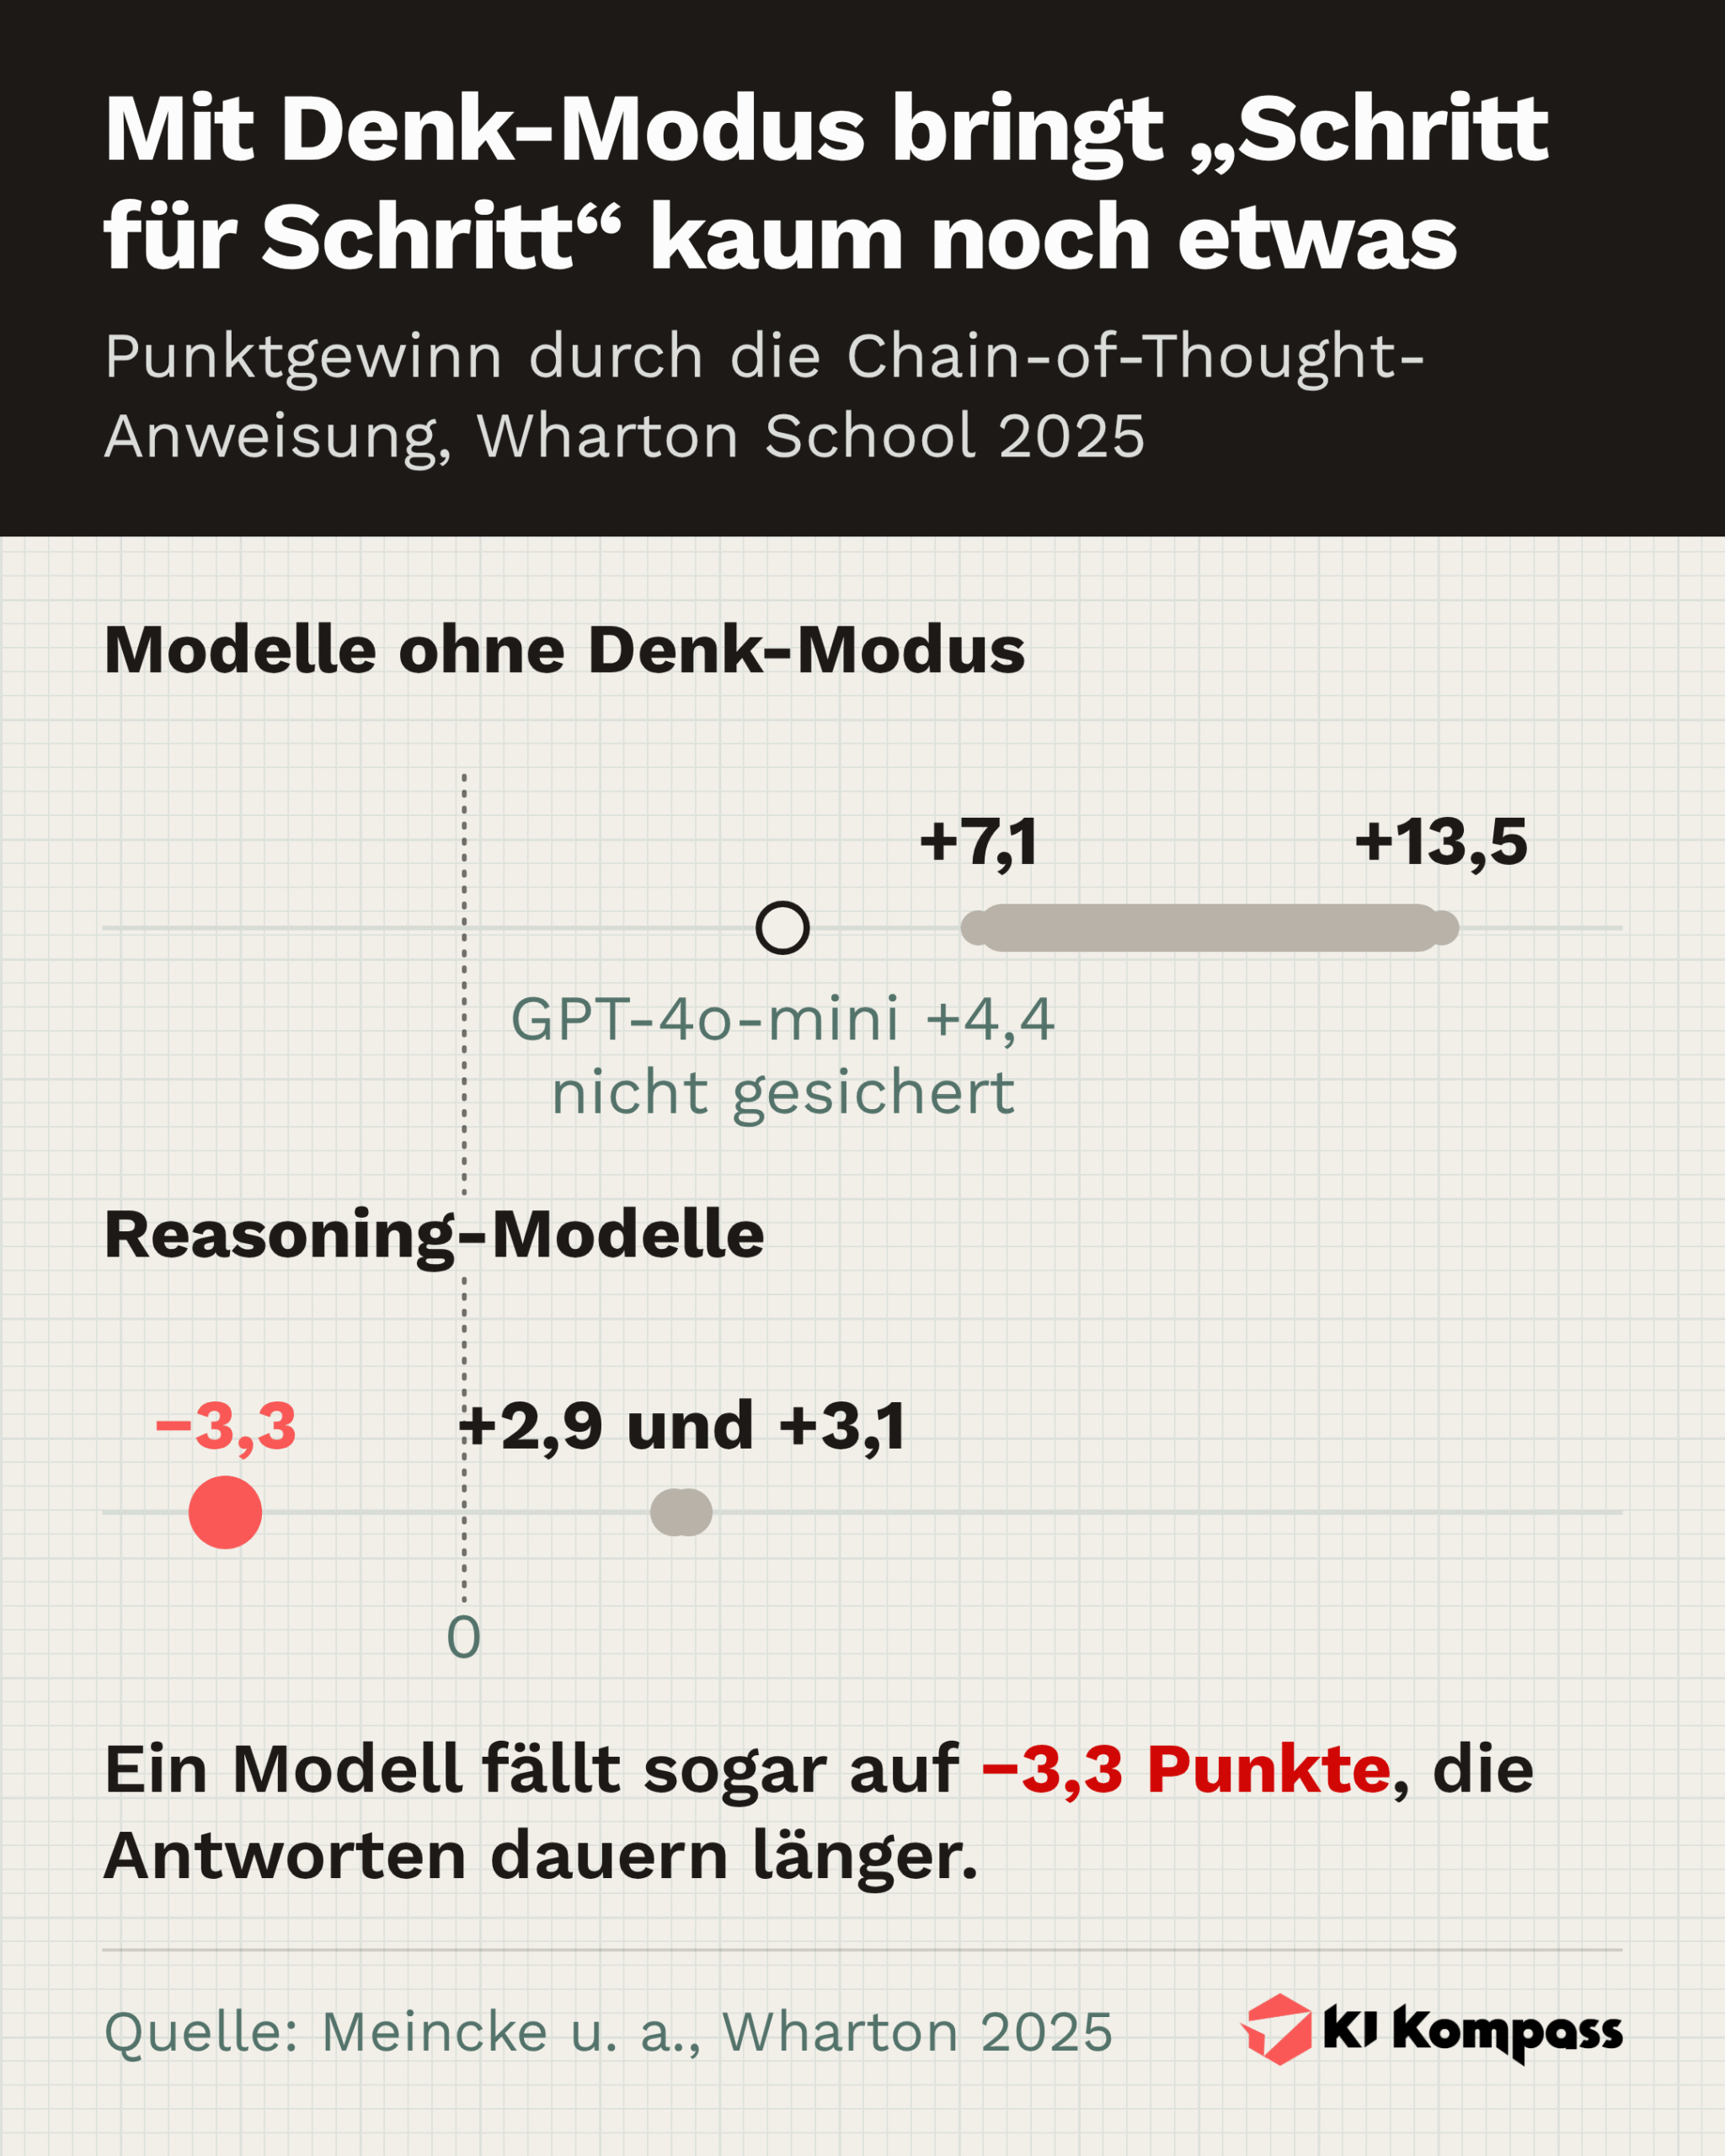
Wie stark der Effekt schwankt, zeigt eine Studie der Wharton School aus dem Jahr 2025. Die Forscher um Lennart Meincke und Ethan Mollick stellten acht Modellen 198 schwierige Multiple-Choice-Fragen aus den Naturwissenschaften, jede 25-mal. Bei Modellen ohne Denk-Modus brachte die Schritt-für-Schritt-Anweisung zwischen 7,1 und 13,5 Prozentpunkte mehr richtige Antworten. Bei einem Modell (GPT-4o-mini, plus 4,4 Punkte) war der Effekt statistisch nicht gesichert.
Bei den drei getesteten Reasoning-Modellen fiel der Gewinn mit 2,9 und 3,1 Prozentpunkten deutlich kleiner aus, beim dritten sank die Trefferquote sogar um 3,3 Punkte. Gleichzeitig dauerten die Antworten der Reasoning-Modelle mit der Anweisung 20 bis 80 Prozent länger.
Bei Reasoning-Modellen bringt die Anweisung also höchstens noch wenig, bei einem der drei Modelle schadete sie sogar. Länger dauert es in jedem Fall.
Zeigen die Denkschritte, was die KI wirklich denkt?
Eine Untersuchung von Anthropic aus dem Jahr 2025 ging der Frage nach, ob Reasoning-Modelle in ihren angezeigten Überlegungen tatsächlich die Faktoren erwähnen, die ihre Antwort beeinflusst haben.
Die Forscher gaben den Modellen versteckte Hinweise auf eine Antwort. Ein getestetes Modell erwähnte einen Hinweis, den es nachweislich genutzt hatte, im Schnitt nur in 25 Prozent der Fälle. In Szenarien, in denen es eine Lücke in der Bewertung ausnutzte, gab es das in weniger als 2 Prozent der Fälle zu. Die sichtbaren Denkschritte spiegelten nicht zwingend die tatsächlichen Entscheidungsgrundlagen wider. Google zeigt bei seinem Modell Gemini ohnehin nur Zusammenfassungen der internen Überlegungen an und keine vollständigen Denkschritte.
Sichtbare Denkschritte beweisen nicht, warum eine KI zu einer bestimmten Antwort gekommen ist. In der Praxis bedeutet das: Prüfe das Ergebnis selbst und verlasse dich nicht blind auf die angezeigte Begründung.
So promptest du heute
Wie ein guter Prompt grundsätzlich aufgebaut ist, erklärt „Prompting“ verständlich erklärt. Für Chain-of-Thought kommt es heute vor allem darauf an, ob dein Modell mit Denk-Modus arbeitet.
Ohne Denk-Modus
Bei schnellen Modellen ohne aktivierten Denk-Modus bleibt die klassische Chain-of-Thought-Anweisung ein nützliches Mittel, besonders bei Rechenaufgaben und mehrstufiger Logik.
Ein Beispiel aus einem steirischen Handwerksbetrieb: Eine Mitarbeiterin lässt einen Rechnungsbetrag mit Mengenrabatt und Skonto berechnen. Gibt sie die Anweisung, jeden Rechenschritt einzeln auszuweisen, lassen sich mögliche Fehler leichter nachvollziehen und korrigieren:
Du bist Buchhalter in einem kleinen österreichischen Handwerksbetrieb. Ein Kunde bestellt MENGE_A Stück Artikel A zu PREIS_A Euro pro Stück und MENGE_B Stück Artikel B zu PREIS_B Euro pro Stück. Ab einem Bestellwert von SCHWELLENWERT Euro gilt ein Rabatt von RABATT_PROZENT Prozent auf die gesamte Bestellung, zusätzlich zieht der Kunde SKONTO_PROZENT Prozent Skonto bei Zahlung innerhalb von ZAHLUNGSFRIST Tagen. Berechne den Rechnungsbetrag.

Denke Schritt für Schritt: Berechne zuerst den Betrag für jeden Artikel einzeln, addiere die Zwischensummen, wende dann den Mengenrabatt an und zum Schluss das Skonto. Zeige jeden Rechenschritt einzeln, bevor du den Endbetrag nennst.
Die Großbuchstaben ersetzt du durch deine Werte. Jeder Zwischenwert steht offen da, und du siehst sofort, an welcher Stelle eine Rechnung kippt.
Mit Denk-Modus
Bei aktiviertem Denk-Modus beschreibst du präzise das Ziel und die Prüfkriterien deiner Aufgabe, statt eine feste Schrittliste vorzugeben.
Ein Beispiel aus einem Wiener Büro: Die Büroleiterin lässt eine mehrdeutige Kundenreklamation einordnen. Die alte Variante mit Schrittliste sah so aus:
Analysiere diese Kundenreklamation Schritt für Schritt:
1. Identifiziere das Hauptproblem
2. Bewerte die Dringlichkeit
3. Schlage eine Lösung vor

Reklamation: TEXT DER REKLAMATION
Für ein Reasoning-Modell passt diese Formulierung besser:
Ordne diese Kundenreklamation ein. Berücksichtige dabei:
- Ist die Reklamation berechtigt?
- Wie dringend ist eine Reaktion erforderlich?
- Welche Lösungsoptionen stehen zur Verfügung, und welche ist am praktikabelsten?

Reklamation: TEXT DER REKLAMATION

Begründe deine Einschätzung nachvollziehbar und schlage eine konkrete nächste Handlung vor.
Anstatt eine feste Abfolge zu diktieren, gibst du dem Modell Ziel und Prüfkriterien vor. Den Weg dorthin überlässt du dem Modell. Genau das empfehlen OpenAI und Anthropic für Modelle mit Denk-Modus.
Übrigens: Eine Weiterentwicklung von Chain-of-Thought ist Self-Consistency. Dabei erzeugt das Modell mehrere unabhängige Denkwege, am Ende gewinnt die Antwort, die am häufigsten herauskommt. Mehr dazu erklären wir in einem eigenen Beitrag zu Tree of Thoughts.
Häufige Fehlannahmen
- „Schritt für Schritt hilft immer“: Bei Reasoning-Modellen ist der Effekt minimal oder negativ und kostet zusätzliche Zeit.
- „Sichtbare Denkschritte erklären die Entscheidung“: Die angezeigten Überlegungen spiegeln nicht immer die tatsächlichen Einflussfaktoren wider.
- „Ohne explizite Anweisung denkt das Modell nicht nach“: Reasoning-Modelle führen ihren internen Denkprozess unabhängig von einer Aufforderung durch.
- „Mehr Anweisungen bringen bessere Ergebnisse“: Bei modernen Modellen zählt die Klarheit von Ziel und Prüfkriterien mehr als eine vorgeschriebene Schrittfolge.
Fazit
Chain-of-Thought-Prompting war 2022 ein bedeutender Durchbruch. Es half Sprachmodellen, komplexe Aufgaben zuverlässiger zu lösen, indem sie ihren Denkweg sichtbar machten. Mit der Einführung von Reasoning-Modellen und deren integriertem Denk-Modus hat sich die Wirkung dieser Technik gewandelt.
Bei schnellen Modellen ohne Denk-Modus bleibt die klassische Anweisung ein bewährtes Mittel für Berechnungen und mehrstufige Logik. Bei Reasoning-Modellen bringt sie dagegen kaum noch etwas und verlängert die Antwortzeit. OpenAI nennt sie dort ausdrücklich unnötig.
Gleichzeitig gilt für alle Modelle: Denkschritte beweisen nicht, wie eine KI tatsächlich zu ihrer Antwort gekommen ist. Die zuverlässigere Strategie besteht heute darin, Ziel und Prüfkriterien klar zu formulieren und das finale Ergebnis kritisch zu prüfen.
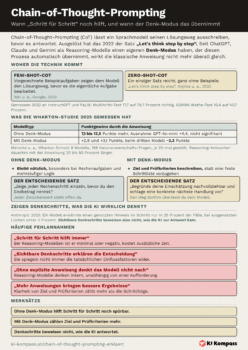
Zum Mitnehmen: Herkunft von Chain-of-Thought, die Wharton-Zahlen zu Modellen mit Denk-Modus, passende Prompt-Sätze für beide Fälle und die vier häufigsten Fehlannahmen auf einer Seite. Als PDF herunterladen oder als Bild speichern.
Tools, die im Artikel erwähnt wurden

ChatGPT
ChatGPT ist für uns weiterhin das Standardwerkzeug, wenn ein einzelnes Tool möglichst viel abdecken soll. In der Breite kommt nur Claude heran, und bei Bildgenerierung und Agentenaufgaben bleibt ChatGPT vorn. Schneller einsatzbereit ist ohnehin keiner. Genau diese Breite ist die Schwäche: Bei quellenbasierter Recherche liefert Perplexity die sauberere Belegkette, bei langen Analysen arbeitet Claude strukturierter. Für Einzelpersonen halten wir Plus für die sinnvolle Stufe, Free und Go sind zu knapp bemessen. Unternehmen raten wir klar zu Business, weil erst dort das Modelltraining mit den eigenen Daten standardmäßig abgeschaltet ist. Wer Kundendaten in den Gratistarif tippt, spart an der falschen Stelle.

Claude
Claude ist für uns das Werkzeug für die lange Form. Wo ein Vertrag, ein Bericht oder eine Codebasis am Stück gelesen werden soll, spielt das Kontextfenster seine Stärke aus, und die Argumentation bleibt sauberer als bei den Allroundern. ChatGPT deckt mehr Disziplinen ab und erzeugt Bilder, Claude nicht. Für Einzelpersonen halten wir Pro für die sinnvolle Stufe. Unternehmen raten wir ab zwei Personen zu Team, weil dort das Training mit den eigenen Inhalten wegfällt. Wer den ganzen Tag im Tool arbeitet, sollte die Fünf-Stunden-Fenster einkalkulieren, sonst steht er am Nachmittag.

Gemini
Drei Wege verkauft Google unter demselben Namen, und wer sie verwechselt, zahlt für das Falsche: das Privatabo Google AI, Gemini im Workspace-Tarif, Gemini Enterprise als eigenes Produkt. Betrieben empfehlen wir den mittleren Weg. Ab Business Standard, 16,20 Euro je Nutzer und Monat, sitzt der Assistent in Gmail, Docs und Sheets, und erst dort lässt sich die EU als Datenregion wählen. Im Microsoft-Haus liefert Microsoft Copilot dieselbe Nähe zum Arbeitsplatz und fällt leichter. Mandanten- und Patientendaten haben im Privatabo nichts verloren, weil der Schutz vor dem Modelltraining dort an einer Einstellung hängt und an keiner Zusage.