Ein KI-Abo wirkt oft unbegrenzt, bis das Limit erreicht ist. Bei einer API-Nutzung zeigt sich der Verbrauch sofort in Dollar. In beiden Fällen ist entscheidend, wie viel Rechenleistung eine konkrete Aufgabe wirklich benötigt.
Die Antwort hängt nicht nur vom gewählten Modell ab. Auch die Effort-Stufe bestimmt mit, wie viele Tokens eine Antwort verbraucht. Wer beide Faktoren passend kombiniert, kann Verbrauch sparen, oft ohne spürbare Abstriche bei der Qualität.
Kurz erklärt
Ein Token ist die Grundeinheit, in der KI-Modelle Text verarbeiten und abrechnen. Jede Aufgabe besteht aus Eingabe- und Ausgabe-Tokens. Bei Reasoning-Modellen kommen Denk-Tokens hinzu. Diese bleiben oft unsichtbar, werden aber von Anbietern wie OpenAI und Google als bezahlte Ausgabe berechnet. Die genaue Funktionsweise behandeln wir im KI KOMPASS Beitrag über Tokens.
Was zählt, ist der Preis der ganzen Aufgabe: wie viele Tokens das Modell braucht, bis ein brauchbares Ergebnis vorliegt. Im Abo spürst du das an schrumpfenden Nutzungslimits, bei der API an der Rechnung.
Warum der Verbrauch wichtiger wird
KI-Abos sind laut einer Analyse von SemiAnalysis (Oktober 2026) stark subventioniert. Ein Vergleich zeigt, dass ein Anthropic-Abo für Claude Opus 5.5 rund fünfmal so viel API-Gegenwert liefert wie ein OpenAI-Abo für GPT-6.1 Sol. Der Vergleich rechnet eine agentische Nutzung zu API-Listenpreisen um und sagt nichts über die Qualität der Modelle für bestimmte Aufgaben.
Bei OpenAI werden die Limits bereits spürbarer: Für neue Abos hat das Unternehmen das Kontingent im 200-Dollar-Tarif gesenkt, laut SemiAnalysis auf rund die Hälfte. Bestandskunden behalten das alte Kontingent laut OpenAI noch bis 29. Oktober 2026. Ob andere Anbieter nachziehen, ist unklar. Auch im Abo ist das Kontingent begrenzt.
Warum billige Tokens teuer werden können
Ein niedriger Listenpreis garantiert keine günstige Erledigung. Ein Modell kann für dieselbe Antwort länger nachdenken, mehr Text generieren oder zusätzliche Durchläufe fordern. Dadurch steigt der Gesamtverbrauch und kann den Preisvorteil zunichtemachen.
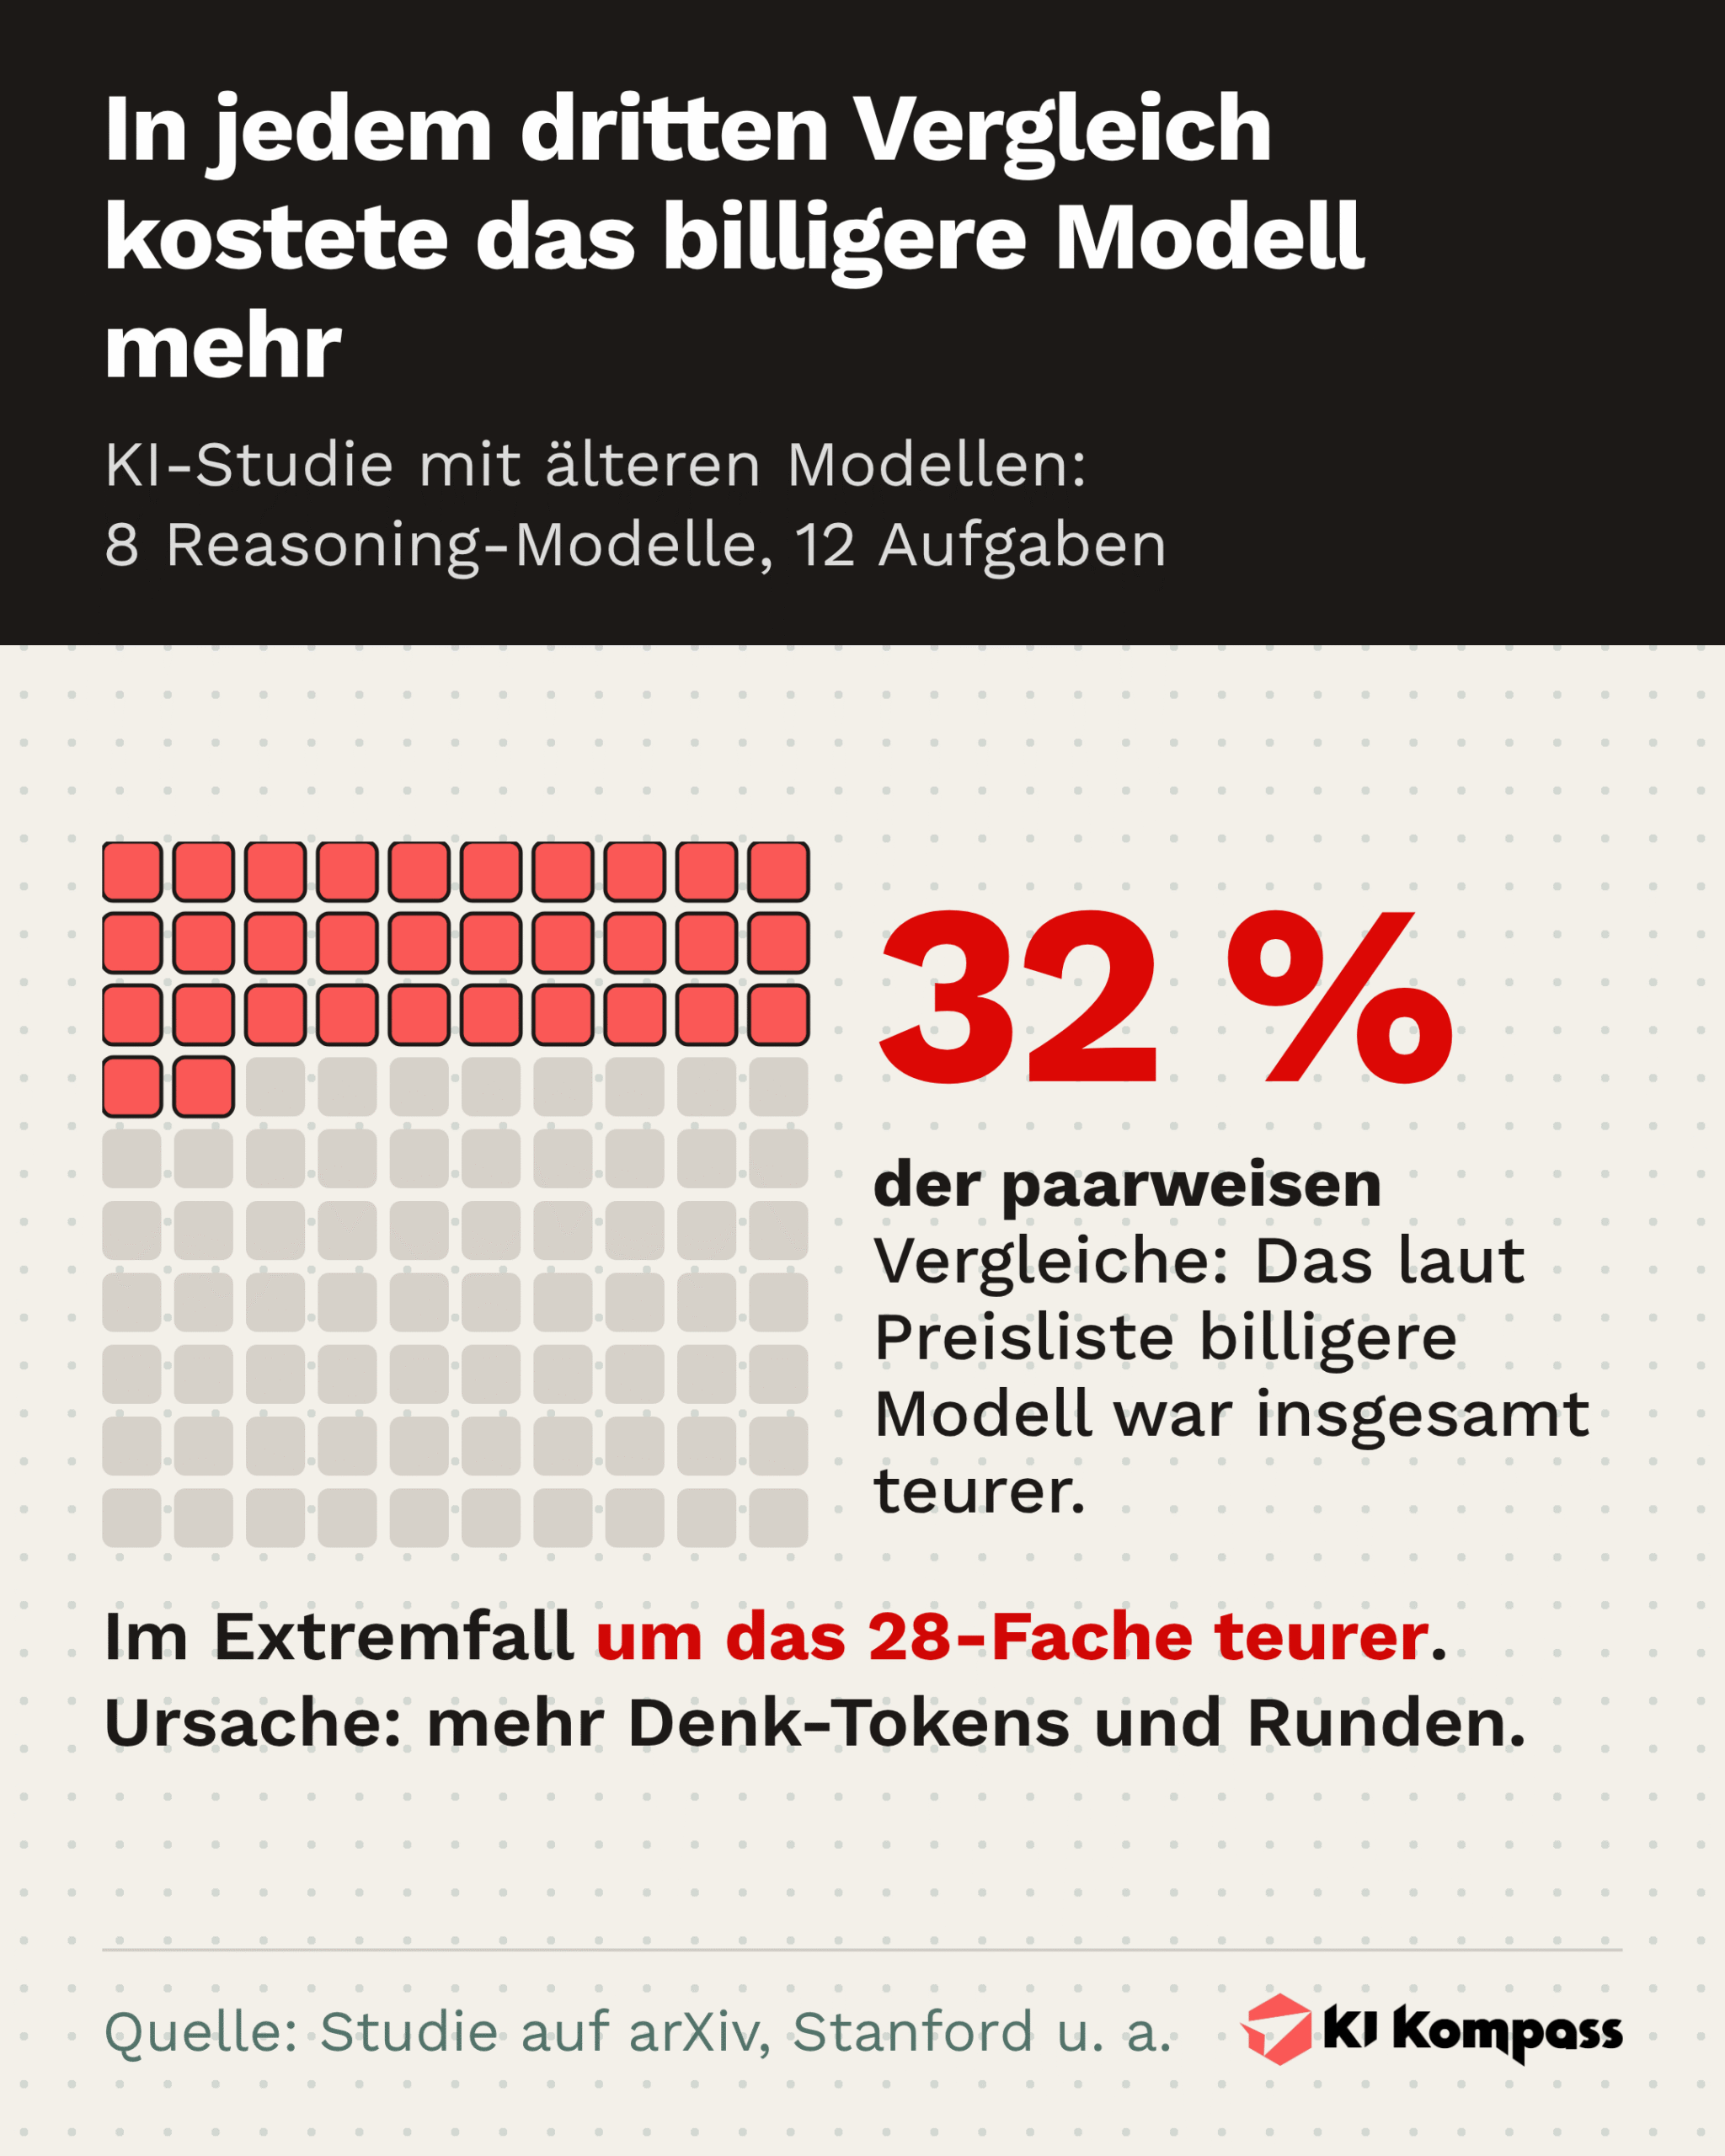
Forscher von Stanford, UC Berkeley, Microsoft Research und Carnegie Mellon haben 8 Reasoning-Modelle an 12 Aufgaben verglichen (Studie auf arXiv). In 32 Prozent der paarweisen Vergleiche (106 von 336) war das laut Preisliste billigere Modell insgesamt teurer, im Extremfall um das 28-Fache. Getestet wurden ältere Modelle wie GPT-5.4 und Gemini 3 Flash, nicht die heutigen. Die Ursache waren unterschiedlich viele Denk-Tokens und Runden. Der reine Tokenpreis taugt nicht als alleiniger Maßstab.
Zwei Regler für eine Aufgabe
Regler 1: das Modell
Große Modelle kosten pro Token mehr, brauchen für anspruchsvolle Aufgaben aber unter Umständen weniger Anläufe. Kleine Modelle sind günstiger und reichen oft für Routinearbeiten. Was am Ende billiger ist, entscheidet der Tokenverbrauch bis zum brauchbaren Ergebnis.
Die folgenden API-Preise gelten pro 1 Million Tokens (Stand 10. Oktober 2026):
| Modell | Eingabe in US-Dollar | Ausgabe in US-Dollar |
|---|---|---|
| Claude Opus 5.5 | 4 | 20 |
| Claude Sonnet 5.5 | 2 | 10 |
| Claude Haiku 5.5 | 0,10 | 0,50 |
| GPT-6.1 Sol | 2 | 10 |
| GPT-6 Luna | 0,10 | 0,50 |
| Gemini 3.8 Flash | 0,75 | 3,75 |
Für Claude Haiku 5.5 gelten diese Preise bei Prompts bis 100.000 Tokens, darüber 0,50 und 2,50 US-Dollar. Bei langem Kontext kosten GPT-6.1 Sol 4 und 15 US-Dollar, GPT-6 Luna 0,20 und 0,75 US-Dollar. Für Gemini 3.8 Flash gelten die Preise laut Google bis 31. Dezember 2026, ab 1. Jänner 2027 kostet es 1,50 US-Dollar (Eingabe) und 7,50 US-Dollar (Ausgabe). Das sind Listenpreise. Was eine konkrete Aufgabe kostet, hängt vom Verbrauch ab.
Regler 2: der Effort
Der Effort (Aufwand) bestimmt, wie intensiv ein Modell an einer Antwort arbeitet. Bei Modellen wie Claude steuert dieser Regler das Nachdenken, die Länge des Antworttextes und mögliche Tool-Aufrufe. Niedrige Stufen sparen Tokens und Zeit. Höhere Stufen können bei komplexen Aufgaben die Qualität verbessern. Anthropic weist darauf hin, dass die Stufe Low die Leistungsfähigkeit leicht einschränkt. Viel Effort ist trotzdem nicht automatisch besser: Bei einfachen Aufgaben bringt er kaum etwas, verbraucht aber mehr Tokens.
Die Bezeichnungen der Stufen variieren je nach Anbieter. Claude nutzt in den Apps die Einteilung Low, Medium, High, Extra high und Max. OpenAI skaliert ähnlich von Low bis Max. Gemini 3.8 Flash beschränkt sich auf Low, Medium und High. Medium ist bei den meisten genannten Modellen voreingestellt: bei Claude Opus 5.5 und Haiku 5.5, GPT-6.1 Sol, GPT-6 Luna und Gemini 3.8 Flash. Claude Sonnet 5.5 startet über die API auf High, in Claude Code auf Medium.
Welche Stufe passt zu welcher Aufgabe?
Die folgende Zuordnung ist eine Faustregel zum Ausprobieren, kein Messergebnis für jede Aufgabe.
| Stufe | Geeignet, wenn … | Beispiel |
|---|---|---|
| Low | du das Ergebnis sofort selbst beurteilen kannst | Ein Angebot freundlicher formulieren |
| Medium | eine normale Aufgabe sorgfältig erledigt werden soll | Stichpunkte zu einem Protokoll ausformulieren |
| High / Extra high | Fehler teuer sind und leicht übersehen werden | Rechnungen auf Unstimmigkeiten prüfen |
| Max | ein Agent lange ohne Kontrolle arbeitet | Dokumente selbstständig sortieren und umbenennen |
Passende Prompts für die jeweiligen Stufen können so aussehen:
Low
Formuliere dieses Angebot an einen Stammkunden freundlicher. Behalte Preise, Leistungen und Fristen unverändert bei: ANGEBOTSTEXTMedium
Erstelle aus diesen Stichpunkten ein sachliches Protokoll. Trenne Beschlüsse, offene Fragen und nächste Schritte. Ergänze keine fehlenden Angaben: STICHPUNKTEHigh oder Extra high
Prüfe diese 40 Lieferantenrechnungen auf doppelte Rechnungsnummern, auffällige Umsatzsteuerangaben und Fremdwährungen. Liste jeden Verdachtsfall mit Rechnungsnummer und Begründung auf. Triff keine Entscheidung, wenn Angaben fehlen: RECHNUNGSDATENMax
Sortiere die Dokumente in diesem Ordner nach Inhalt in Unterordner und benenne sie nach dem Schema DATUM_ABSENDER_DOKUMENTART um. Dokumentiere jede Änderung. Wenn ein Dokument nicht eindeutig zuzuordnen ist, ändere es nicht und vermerke den Grund: ORDNERINHALTBei sensiblen Daten wie Rechnungen oder Verträgen bleibt die menschliche Prüfung unverzichtbar. Ein höherer Effort macht die KI gründlicher, ersetzt aber keine fachliche Endkontrolle.
Die Kombination aus Modell und Effort lässt Spielraum. Ein starkes Modell auf der Stufe Low ist unter Umständen günstiger als ein kleines Modell auf Max. Umgekehrt löst ein kleines Modell mit maximalem Aufwand vielleicht eine Aufgabe, an der es bei niedrigem Effort scheitert. Dieser Abgleich erfordert Tests mit eigenen Daten.
Warum du das Modell im Chat nicht wechseln solltest
Die KI benötigt den bisherigen Chatverlauf als Kontext für jede neue Antwort. Um Rechenleistung zu sparen, nutzen Anbieter einen Cache. Dieser Zwischenspeicher macht bereits verarbeitete Eingaben günstiger verfügbar. Bei Claude hat laut Anthropic jedes Modell seinen eigenen Cache, bei anderen Anbietern ist das ähnlich angelegt. Wechselst du das Modell mitten im Chat, muss die neue KI den gesamten Verlauf frisch einlesen. Der bisherige Preisvorteil verfällt.
Das spürst du an den Kosten. Bei Claude Opus 5.5, Claude Sonnet 5.5 und GPT-6.1 Sol kostet das Lesen zwischengespeicherter Eingaben nur 5 Prozent des regulären Eingabepreises. Zwar liegt nicht immer der gesamte Chat im Cache, bei Claude etwa verfällt er standardmäßig 5 Minuten nach der letzten Nutzung. Der Preisunterschied verdeutlicht jedoch, warum ein fliegender Modellwechsel den Tokenverbrauch unnötig in die Höhe treibt.
Sinnvoller ist ein Wechsel zwischen zwei Arbeitsschritten. Starte für eine neue Aufgabe einfach einen neuen Chat mit dem passenden Modell. Wenn du bei Claude Opus 5.5, Sonnet 5.5 oder Haiku 5.5 lediglich die Effort-Stufe anpasst, bleibt der Cache laut Anthropic erhalten.
So findest du die beste Einstellung
Aufwendige Testreihen sind dafür nicht nötig. Nutze stattdessen Aufgaben, die in deinem Arbeitsalltag regelmäßig anfallen:
- Beginne auf Low und prüfe, ob die Qualität für diese spezielle Aufgabe ausreicht.
- Fehlt es an Präzision, schalte eine Stufe höher und vergleiche das Ergebnis.
- Behalte im Abo die Verbrauchsanzeige im Blick. Bei der API achtest du auf den Tokenverbrauch und die Dollarkosten.
- Notiere dir, welche Kombination aus Modell und Effort für deinen Anwendungsfall verlässlich funktioniert.
Vermeide typische Anfängerfehler: Nutze Extra high nicht für triviale Aufgaben, wähle das Modell nicht blind nach der Preisliste und wechsle die KI nicht in laufenden Chats. Auch der höchste Effort macht eine abschließende Kontrolle durch den Menschen nicht überflüssig.
Fazit
Was KI kostet, hängt am Verbrauch bis zum brauchbaren Ergebnis. Diesen Verbrauch steuerst du mit zwei Einstellungen: Modell und Effort. Für leicht kontrollierbare Routineaufgaben reicht oft die Stufe Low. Sobald übersehene Fehler Geld kosten, ist mehr Gründlichkeit geboten. Welche Kombination passt, zeigt ein kurzer Test mit deinen eigenen, wiederkehrenden Aufgaben.
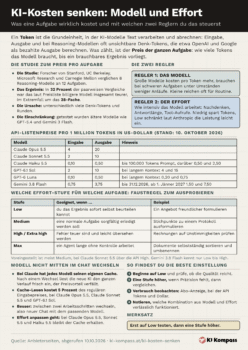
Zum Mitnehmen: die API-Preise von sechs Modellen, die Effort-Faustregel von Low bis Max, die Studie zum Preis pro Aufgabe und die Cache-Regel zum Modellwechsel auf einer Seite (Stand Oktober 2026). Als PDF herunterladen oder als Bild speichern.
Tools, die im Artikel erwähnt wurden

Claude
Claude ist für uns das Werkzeug für die lange Form. Wo ein Vertrag, ein Bericht oder eine Codebasis am Stück gelesen werden soll, spielt das Kontextfenster seine Stärke aus, und die Argumentation bleibt sauberer als bei den Allroundern. ChatGPT deckt mehr Disziplinen ab und erzeugt Bilder, Claude nicht. Für Einzelpersonen halten wir Pro für die sinnvolle Stufe. Unternehmen raten wir ab zwei Personen zu Team, weil dort das Training mit den eigenen Inhalten wegfällt. Wer den ganzen Tag im Tool arbeitet, sollte die Fünf-Stunden-Fenster einkalkulieren, sonst steht er am Nachmittag.

ChatGPT
ChatGPT ist für uns weiterhin das Standardwerkzeug, wenn ein einzelnes Tool möglichst viel abdecken soll. In der Breite kommt nur Claude heran, und bei Bildgenerierung und Agentenaufgaben bleibt ChatGPT vorn. Schneller einsatzbereit ist ohnehin keiner. Genau diese Breite ist die Schwäche: Bei quellenbasierter Recherche liefert Perplexity die sauberere Belegkette, bei langen Analysen arbeitet Claude strukturierter. Für Einzelpersonen halten wir Plus für die sinnvolle Stufe, Free und Go sind zu knapp bemessen. Unternehmen raten wir klar zu Business, weil erst dort das Modelltraining mit den eigenen Daten standardmäßig abgeschaltet ist. Wer Kundendaten in den Gratistarif tippt, spart an der falschen Stelle.

Gemini
Drei Wege verkauft Google unter demselben Namen, und wer sie verwechselt, zahlt für das Falsche: das Privatabo Google AI, Gemini im Workspace-Tarif, Gemini Enterprise als eigenes Produkt. Betrieben empfehlen wir den mittleren Weg. Ab Business Standard, 16,20 Euro je Nutzer und Monat, sitzt der Assistent in Gmail, Docs und Sheets, und erst dort lässt sich die EU als Datenregion wählen. Im Microsoft-Haus liefert Microsoft Copilot dieselbe Nähe zum Arbeitsplatz und fällt leichter. Mandanten- und Patientendaten haben im Privatabo nichts verloren, weil der Schutz vor dem Modelltraining dort an einer Einstellung hängt und an keiner Zusage.