KI-Projekte scheitern selten an der Technologie. Sie scheitern an einem unscharfen Start: zu viele Ziele, zu wenig Struktur, keine Messbarkeit. Ein klar aufgesetztes Pilotprojekt schafft einen kontrollierten Rahmen. Hier prüfst du Machbarkeit, Risiken und Nutzen einer KI-Anwendung, bevor du sie in die Fläche bringst.
Dieser Leitfaden zeigt, wie du einen KI-Testlauf planst, durchführst und bewertest. Am Ende steht eine belastbare Entscheidung: skalieren, anpassen oder stoppen.
Kurz erklärt: Was ist ein KI-Pilotprojekt?
Ein KI-Pilotprojekt ist ein zeitlich begrenzter, eng umrissener Testlauf. Du prüfst darin eine konkrete Hypothese, mit echten Anwendern, realen Daten und messbaren Zielen.
Die wichtigsten Merkmale im Überblick:
- Klarer Scope: Ein definierter Prozess anstelle von „alles mal ausprobieren“.
- Messbares Ziel: Zum Beispiel „Bearbeitungszeit um 20 Prozent senken“ oder „Trefferquote von 95 Prozent erreichen“.
- Begrenzter Zeitraum: Meist vier bis acht Wochen mit einer festen Testgruppe.
- Echte Nutzung: Fachanwender arbeiten im Alltag mit der KI, Menschen kontrollieren die Ergebnisse.
- Objektive Bewertung: Am Ende steht der Vergleich mit einer Baseline.
Damit ist ein Pilotprojekt kein bloßer Techniktest. Es ist ein strukturierter Versuchsaufbau, der die spätere Skalierungsentscheidung vorbereitet.
1. Die Hypothese: Konzept und Fokus festlegen
Der Startschuss fällt nicht bei der Auswahl der Tools, sondern bei der Frage, was du eigentlich herausfinden willst. Du beginnst mit einer klaren Hypothese.
Beispiele für solche Hypothesen:
- „Eine KI klassifiziert eingehende Kundenservice-Mails automatisch. Dadurch sinkt die durchschnittliche Bearbeitungszeit pro Ticket.“
- „Eine KI extrahiert strukturierte Daten aus Standarddokumenten. Dadurch entfallen manuelle Erfassungsschritte im Backoffice.“
Diese Hypothese muss sich auf einen konkreten Prozess beziehen, durch messbare Kriterien prüfbar sein und in einem überschaubaren Zeitraum getestet werden können.
Anschließend definierst du den Scope. Welche E-Mails genau? Welche Dokumententypen? Welche Sprachen und Teams? Alles, was nicht zwingend zum Prüfziel gehört, klammerst du konsequent aus. Je schärfer der Scope, desto eindeutiger die Ergebnisse. Du lässt im Piloten bewusst Unsicherheit zu, aber in einem eng abgesicherten Rahmen.
2. Der Rahmen: Bedingungen für den Testlauf definieren
Steht die Hypothese, baust du den Rahmen für den Test. Vier Punkte sind hier entscheidend:
Zeitraum und Umfang
Vier bis acht Wochen sind ein guter Richtwert. Das ist kurz genug für schnelles Lernen und lang genug, um belastbare Daten zu sammeln. Lege vorab fest, wie viele Fälle (etwa E-Mails oder Dokumente) in dieser Zeit mindestens durch die KI laufen müssen.
Testgruppe und Rollen
Wer arbeitet mit der KI? Wer beurteilt die Ergebnisse? Du brauchst eine fachliche Testgruppe aus der Praxis, eine Projektverantwortung für den Versuchsaufbau und idealerweise eine Person, die Kennzahlen und Auswertungen im Blick behält.
Erfolgskriterien
Wann ist der Pilot erfolgreich? Definiere harte Kriterien wie eine Mindestgenauigkeit bei der Klassifizierung, eine maximale Fehlerrate bei der Extraktion oder eine prozentuale Zeitersparnis.
Die Baseline
Vor dem Start brauchst du zwingend einen Ausgangswert, den Ist-Zustand. Wie lange dauert die Bearbeitung heute? Wie viele Fehler passieren bei der manuellen Erfassung? Ohne diese Baseline bleibt der Testlauf ein subjektives Stimmungsbild. Mit ihr wird er zu einem objektiv auswertbaren Experiment.
3. Die Basis: Daten und Compliance vorab sichern
Bevor die KI das erste reale Dokument verarbeitet, müssen Datenqualität, Datenschutz und Freigaben geregelt sein.
Datenqualität und Zugänglichkeit
Die beste KI scheitert an schlechten Daten. Lege genau fest, welche Datenquellen du anbindest. Achte darauf, dass die Daten repräsentativ sind. Sie müssen neben einfachen Standardfällen auch typische Ausnahmen und schwierige Varianten enthalten. Zudem müssen sie in einem verarbeitbaren Format vorliegen, beispielsweise als saubere Scans oder mit konsistenten Labels.
Datenschutz und Rechtliches
Kläre beim Einsatz externer KI-Dienste frühzeitig, ob personenbezogene Daten verarbeitet werden und auf welcher Rechtsgrundlage das passiert. Auftragsverarbeitungsverträge müssen vorliegen. Für den Start reicht es oft, mit pseudonymisierten Daten zu arbeiten, solange das den Test nicht verfälscht. Binde Datenschutz und IT-Sicherheit direkt zu Beginn ein, nicht erst kurz vor dem Go-live.
Interne Freigaben
Parallel klärst du die internen Spielregeln. Welche KI-Tools sind im Unternehmen erlaubt? Dürfen Prompts gespeichert oder Daten für das Training der Modelle genutzt werden? Welche technischen Schnittstellen sind zugelassen? Fehlen diese Freigaben, droht dem Projekt spätestens in der Umsetzung der Stopp.
4. Die Umsetzung: Iterativ testen und anpassen
Der Pilot ist gestartet. Jetzt gilt: Ein Testlauf ist kein einmaliges Event, sondern ein iterativer Prozess.
Start mit enger Kontrolle
Zu Beginn prüft die Testgruppe jedes KI-Ergebnis systematisch. Landet die E-Mail in der richtigen Kategorie? Stimmen die ausgelesenen Daten? Wo häufen sich Fehler? Die Fachanwender korrigieren die Ausgaben und dokumentieren alle Auffälligkeiten.
Standardisiertes Feedback
Um das Feedback der Testgruppe auswerten zu können, brauchst du einen standardisierten Bewertungs-Prompt.
Beispiel-Prompt:
Bewerte das KI-Ergebnis fachlich entlang dieser Kriterien: 1. Vollständigkeit, 2. Richtigkeit, 3. Verständlichkeit. Vergib pro Kriterium eine Schulnote von 1 bis 5 und ergänze maximal zwei kurze Hinweise zur Verbesserung.So verhinderst du, dass am Ende nur anekdotische Einzelmeinungen stehen. Du erhältst stattdessen auswertbare Daten.
Laufende Nachschärfung
Auf Basis dieses Feedbacks passt du den Piloten kontinuierlich an. Du veränderst Prompts, trainierst Klassifikationen nach oder passt den Scope an, wenn bestimmte Fälle systematisch scheitern. Wichtig: Dokumentiere jede Änderung. Nur so weißt du später, welche Anpassung zu welcher Leistung geführt hat.
5. Die Auswertung: Baseline-Vergleich und Erfolgsmessung
Nach vier bis acht Wochen ziehst du Bilanz. Der Kern dieser Auswertung ist der Vergleich zwischen Baseline und Pilot-Ergebnis.
Dabei betrachtest du vier Dimensionen:
Qualität: Wie oft lag die KI richtig? Welche Fehler sind passiert und wie unterscheiden sie sich von den bisherigen manuellen Fehlern?
Zeit und Aufwand: Hat sich die Bearbeitungszeit pro Vorgang messbar verändert? Frisst ein neuer Kontrollschritt die gewonnene Zeit direkt wieder auf?
Kosten-Nutzen-Verhältnis: Wie verhalten sich die eingesparten Aufwände zu den Lizenz- und Implementierungskosten? Für einen Piloten reicht hier eine grobe Relation, ein komplexes ROI-Modell ist noch nicht nötig.
Risiken: Gab es kritische Ausreißer? Sind neue Herausforderungen bei Datenschutz oder Haftung aufgetaucht?
An diesem Punkt zahlt sich die saubere Vorbereitung aus. Du diskutierst jetzt nicht über Bauchgefühl, sondern über belegbare Effekte.
Die Entscheidung: Skalieren, anpassen oder stoppen
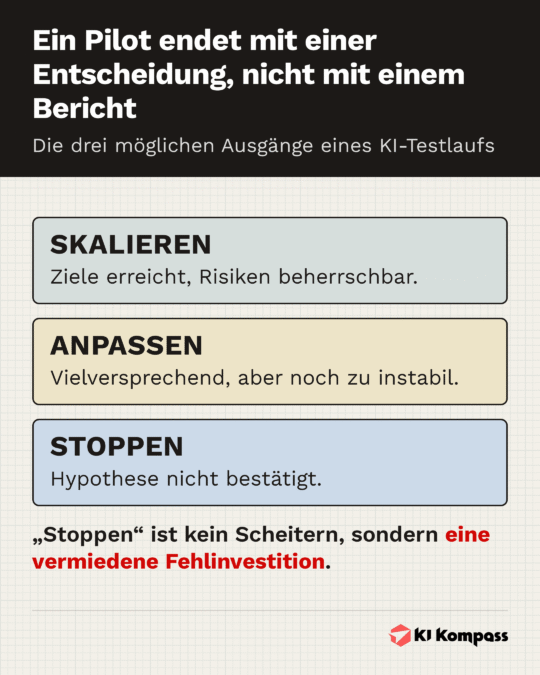
Aus den gesammelten Daten leitest du eine von drei möglichen Entscheidungen ab.
1. Skalieren
Die KI erreicht die Qualitätsziele, spart Zeit und die Risiken sind im Griff. Der nächste Schritt ist die Ausweitung auf weitere Teams oder Prozesse, begleitet von Schulungen und Change-Management.
2. Methodisch anpassen
Die Ergebnisse sind vielversprechend, aber noch zu instabil. In diesem Fall startest du einen zweiten, veränderten Piloten. Du schärfst den Scope, wechselst das Modell oder verbesserst die Datenbasis.
3. Projekt stoppen
Die Hypothese hat sich nicht bestätigt. Der Aufwand rechtfertigt den Nutzen nicht oder die fachlichen Risiken sind zu hoch. Das ist kein Scheitern, sondern ein wertvolles Ergebnis: Du hast mit geringem Aufwand Klarheit geschaffen und eine teure Fehlinvestition vermieden.
Konkrete Use Cases aus der Praxis
Wie diese Systematik in der Praxis aussieht, zeigen zwei typische Beispiele.
Use Case 1: E-Mail-Klassifizierung im Kundenservice
- Hypothese: Eine KI ordnet Mails automatisch richtig zu. Dadurch sinken Bearbeitungszeit und Weiterleitungsfehler.
- Scope: Ausschließlich deutschsprachige Anfragen von Bestandskunden.
- Datenbasis: Historische E-Mails zur Konfiguration sowie klare Definitionen der Fachkategorien.
- Testphase: Sechs Wochen. Eine Service-Gruppe prüft und bewertet alle KI-Vorschläge.
- Messung: Abgleich von Bearbeitungszeit, Fehlleitungsquote und Mitarbeiterbelastung vor und nach dem Test.
- Entscheidung: Skalierung bei stabiler Zuordnung und echter Zeitersparnis. Stopp bei zu hoher Fehlerquote und dadurch steigendem Kontrollaufwand.
Use Case 2: Datenextraktion im Backoffice
- Hypothese: Eine KI extrahiert strukturierte Daten aus Standardformularen, sodass die manuelle Abtipparbeit entfällt.
- Scope: Nur digital vorliegende PDFs eines spezifischen Formulartyps.
- Datenbasis: Musterbeispiele mit bereits manuell korrekt erfassten Daten als Referenz.
- Testphase: Vier Wochen. Mitarbeitende kontrollieren jede extrahierte Information auf Vollständigkeit und Fehler.
- Messung: Vergleich von Erfassungszeit und Fehlerquote mit der bisherigen manuellen Methode.
- Entscheidung: Skalierung, wenn Genauigkeit und Tempo im Zielbereich liegen. Anpassung, wenn die KI bestimmte Datenfelder konsequent übersieht.
Fazit: Warum sich die Struktur auszahlt
Ein KI-Pilotprojekt ist mehr als ein reiner Techniktest. Es ist ein Instrument, das dir exakt zeigt, unter welchen Bedingungen Künstliche Intelligenz in deinem Betrieb Nutzen stiftet, und wo ihre Grenzen liegen.
Wenn du eine klare Hypothese formulierst, den Scope und die Baseline definierst, Datenqualität und Freigaben klärst, Anwender für standardisiertes Feedback einbindest und die Ergebnisse objektiv vergleichst, passiert etwas Entscheidendes: Aus einem vagen „Wir probieren mal KI aus“ wird ein professioneller Entscheidungsprozess.
Die Stärke dieses Vorgehens liegt darin, Unsicherheit abzubauen. Nicht durch blinden Optimismus oder pauschale Skepsis, sondern durch harte, beobachtbare Daten. So liefert der Testlauf genau das, was du vor einer Skalierung brauchst: ein verlässliches Fundament.
Tool
Pilotprojekt-Steckbrief
Vier Angaben ergeben einen Steckbrief, mit dem dein KI-Testlauf am Ende auswertbar ist. Dazu bekommst du den Bewertungs-Prompt für die Testgruppe, schon mit deinen Angaben befüllt.
1. Die Hypothese
Welchen Prozess willst du testen und was soll dabei besser werden?
2. Der Rahmen
Kurz genug zum schnellen Lernen, lang genug für belastbare Daten.
Zum Beispiel Mails, Dokumente oder Anfragen. Ganze Zahl.
Rollen oder Team genügt, keine Namen nötig.
3. Baseline und Erfolgskriterium
Ohne Ausgangswert bleibt der Testlauf ein Stimmungsbild.
4. Das Abbruchkriterium
Vorab festgelegt, damit die Entscheidung am Ende sachlich bleibt.
Dein Pilotprojekt-Steckbrief
Bewertungs-Prompt für die Testgruppe
Damit aus Einzelmeinungen auswertbare Daten werden.
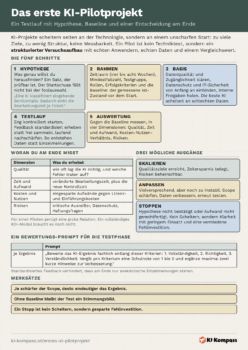
Zum Mitnehmen: Die fünf Schritte, woran du misst, drei mögliche Ausgänge und ein Bewertungs-Prompt. Als PDF herunterladen oder als Bild speichern.